Teste A/B server-side: CRO confiável sem piscar a página
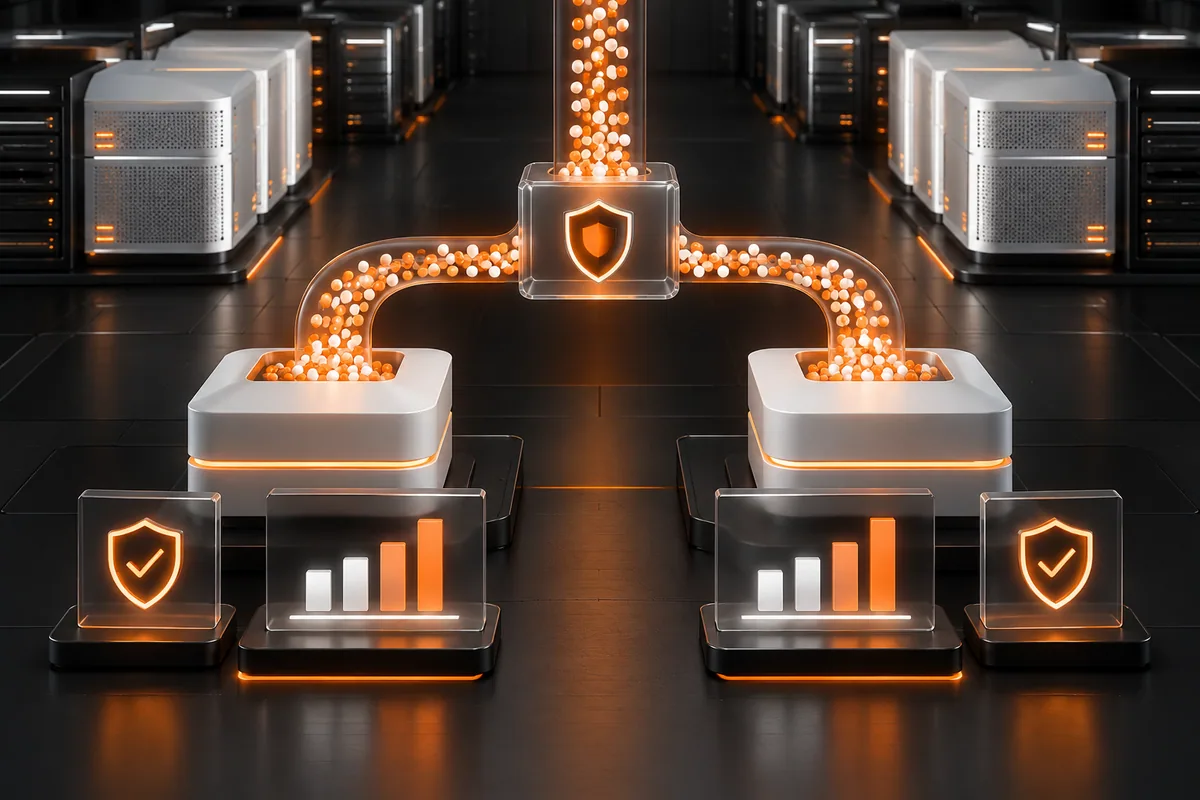
Resposta direta: um teste A/B server-side escolhe a variante antes de montar a resposta, evitando a troca visual tardia comum em ferramentas client-side. Para ser confiável, precisa randomizar uma unidade estável, registrar exposição real, verificar Sample Ratio Mismatch, definir métrica principal e guardrails e tratar SEO, cookies e privacidade. Mudar a tecnologia não corrige um desenho experimental ruim.
Esse modelo é útil para preço, checkout, busca, algoritmo, fluxo autenticado e mudanças que envolvem servidor. Também pode simplificar desempenho, porque não exige baixar uma página e depois substituí-la por JavaScript.
Client-side e server-side
No client-side, a página base chega e um script decide ou aplica a variante. É rápido de configurar para texto e layout, mas pode gerar flicker, dependência de terceiro e atraso.
No server-side, a requisição recebe uma atribuição e o servidor renderiza a variante desde o início. A experiência é estável, porém exige engenharia, observabilidade e controle de release.
Os modelos podem coexistir. Escolha conforme risco e camada da mudança.
Comece por hipótese, não por ferramenta
Uma hipótese liga problema, mudança, público e resultado: “Explicar prazo antes do formulário aumentará envios qualificados sem elevar cancelamentos”.
Defina a métrica principal antes de olhar resultados. Adicione guardrails de receita, margem, erro, velocidade, suporte e qualidade.
Escreva critérios de parada, população elegível e duração mínima. Isso reduz decisões oportunistas.
Unidade de randomização
Escolha usuário, conta, dispositivo ou sessão. Em produto B2B, randomizar por usuário pode mostrar variantes diferentes a pessoas da mesma empresa; randomizar por conta evita contaminação.
Visitantes anônimos podem receber um identificador first-party. Após login, defina se a atribuição migra ou se a conta prevalece.
Não altere a unidade no meio do teste. Documente bots, funcionários e ambientes excluídos.
Atribuição determinística
Use um hash estável de identificador e experimento para escolher bucket. A mesma pessoa deve receber a mesma variante durante o período, salvo regra explícita.
Uma feature flag controla qual implementação é entregue; a camada experimental controla distribuição e análise. Não confunda ativar recurso com provar impacto.
Tenha kill switch para desligar o tratamento sem deploy completo.
Registro de exposição
Não conte toda pessoa elegível como exposta. Registre exposição quando a variante realmente afeta a experiência. Isso evita diluir efeito com usuários que nunca alcançaram o componente.
O evento deve conter experimento, variante, unidade, horário e versão, sem dados pessoais desnecessários.
Deduplicate exposições para análise de usuários, mas preserve eventos quando a métrica exige sessões.
Sample Ratio Mismatch
SRM ocorre quando a proporção observada entre controle e tratamento difere significativamente da planejada. A Microsoft trata o teste como sinal de problema de qualidade e recomenda não tirar conclusões antes de investigar.
Causas incluem falha de atribuição, cache que favorece uma variante, perda de eventos, filtros pós-tratamento, diferenças de compatibilidade e ativação parcial.
Execute verificação de SRM antes de analisar efeito. Um resultado “vencedor” com SRM pode ser viés.
Cache e CDN
Uma CDN pode servir a variante de uma pessoa para outras se a chave de cache ignora atribuição. Defina Vary, cache privado, segmentação na borda ou renderização adequada.
Não inclua identificadores individuais na chave sem avaliar explosão de cache e privacidade. Prefira poucos buckets controlados.
Teste respostas anônimas, autenticadas, bots e regiões.
Cookies com segurança
Quando usar cookie first-party, limite duração e escopo. Secure envia em HTTPS; HttpOnly impede leitura por JavaScript quando o cookie não precisa do cliente; SameSite controla contexto entre sites.
O prefixo e o atributo corretos ajudam a reduzir alteração indevida, mas não substituem consentimento, minimização e proteção no servidor.
Não grave variante junto com e-mail ou telefone em URL.
SEO sem cloaking
O Google recomenda não mostrar conteúdo específico ao Googlebot diferente do usuário. Isso é cloaking, independentemente de a decisão ocorrer no servidor.
Se variantes usam URLs distintas, indique a original como canonical e use redirect 302 temporário, não 301 permanente. Remova o experimento quando terminar.
Com cookies, o Googlebot geralmente verá a versão disponível sem cookie. Essa versão deve ser legítima para usuários equivalentes.
Experimentos de conteúdo
Pequenas mudanças em CTA e layout tendem a ter baixo risco de busca. Alterar conteúdo principal, links ou estrutura em larga escala exige revisão SEO.
Não deixe URLs de teste indexáveis sem canonical. Evite noindex quando a intenção é consolidar versões da mesma página.
Monitore rastreamento, canonicals selecionadas e tráfego orgânico como guardrail.
Métrica principal e guardrails
A métrica principal responde à hipótese: compra, lead qualificado ou ativação. Guardrails impedem um ganho aparente que prejudica margem, velocidade, devolução ou satisfação.
Defina métricas de qualidade de dados: exposição ausente, evento duplicado, erro, SRM e distribuição por plataforma.
Uma mudança pode melhorar clique e piorar conclusão. Avalie o funil sem transformar cada etapa em hipótese principal.
Duração e significância
Calcule amostra com efeito mínimo relevante, baseline e poder estatístico. Um teste não deve parar no primeiro p-valor favorável.
Respeite ciclos de dia da semana, atraso de conversão e sazonalidade. Não prolongue indefinidamente; a documentação do Google recomenda manter experimentos apenas pelo tempo necessário.
Relate intervalo de confiança e tamanho do efeito, não só “ganhou” ou “perdeu”.
Novidade e aprendizagem
Usuários podem reagir ao novo e depois voltar ao comportamento anterior. Para mudanças permanentes, verifique estabilidade ao longo do tempo.
Não exponha a mesma população a muitos testes conflitantes sem camada de exclusão. Interações podem distorcer resultados.
Mantenha catálogo de experimentos, variantes e dependências.
Exemplo em formulário B2B
O controle pede todos os dados de uma vez. O tratamento divide em duas etapas e explica a finalidade. O servidor atribui por visitante e entrega HTML completo.
A métrica principal é lead qualificado; guardrails são abandono, tempo, erro e solicitações inválidas. O CRM devolve o estágio.
Se envio aumenta, mas qualificação cai, o tratamento não é vencedor.
Exemplo em checkout
Um e-commerce testa estimativa de frete mais cedo. Randomiza por usuário e registra exposição quando o bloco aparece.
Mede compra e margem; guarda cancelamento, erro de frete, latência e suporte. A CDN varia somente pelo bucket do experimento.
O rollout começa gradual e mantém kill switch.
Exemplo em busca interna
O tratamento usa novo ranking. A atribuição acontece por usuário, mas consultas e cliques precisam de cuidado para não expor conteúdo pessoal.
A métrica combina sucesso da busca e conversão. Guardrails incluem zero resultados, latência e diversidade.
Equipes analisam segmentos definidos antes, sem caçar grupos vencedores depois.
Processo operacional
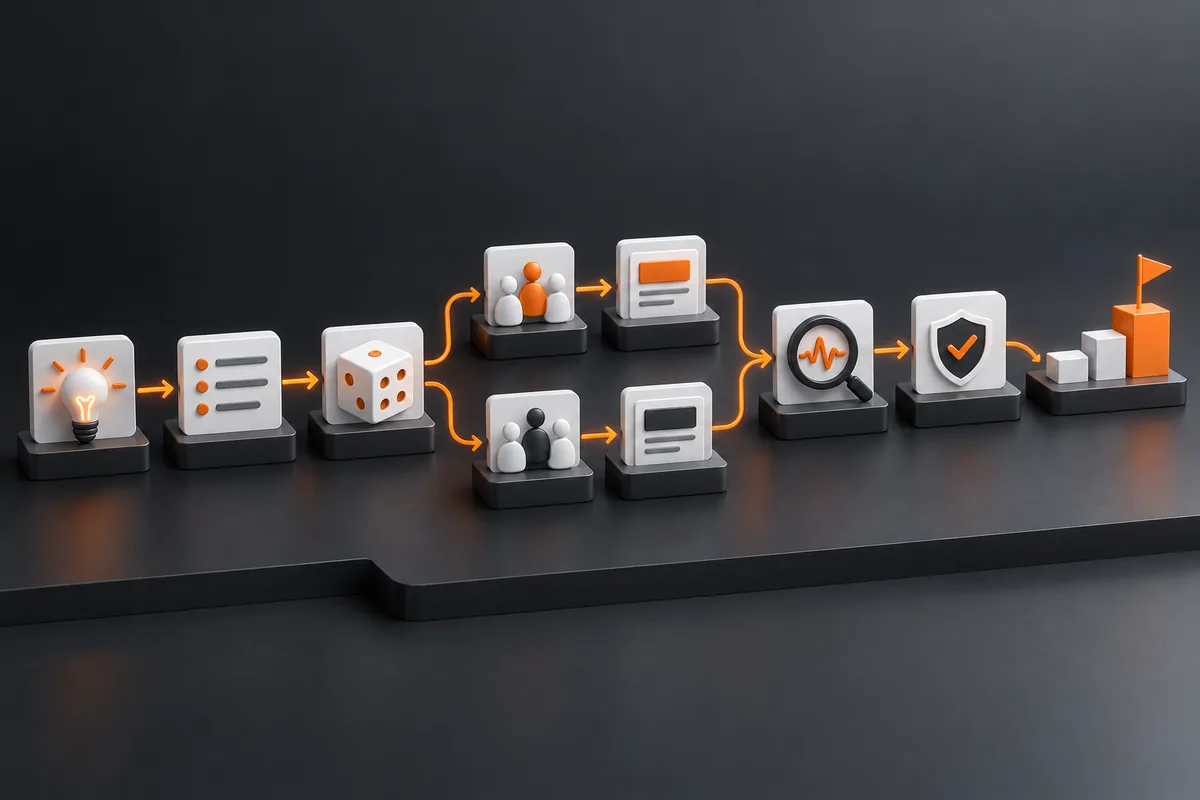
- Documente hipótese e risco.
- Escolha unidade e população.
- Calcule amostra.
- Implemente atribuição e exposição.
- Valide cache e cookies.
- Execute teste A/A quando necessário.
- Monitore SRM e erros.
- Aguarde janela planejada.
- Analise efeito e guardrails.
- Decida lançar, iterar ou descartar.
- Remova código e URLs antigas.
Checklist técnico
- Hipótese tem efeito mínimo relevante.
- Unidade de randomização é estável.
- Exposição é registrada no momento certo.
- Controle e tratamento têm versões rastreáveis.
- SRM é calculado antes do efeito.
- Cache não mistura variantes.
- Cookie é first-party e minimizado.
- SEO não depende de user-agent.
- URLs alternativas usam canonical.
- Redirect de teste é temporário.
- Guardrails incluem performance e receita.
- Kill switch foi testado.
Erros frequentes
Erros comuns incluem randomizar por sessão quando a decisão é por usuário, contar elegíveis como expostos, ignorar SRM e interromper no primeiro sinal positivo.
Também aparecem cache contaminado, eventos duplicados, teste permanente, cloaking e métrica superficial. Server-side reduz flicker; não reduz a necessidade de método.
Teste A/A antes de confiar na plataforma
Em um teste A/A, os dois braços entregam a mesma experiência. Ele ajuda a verificar randomização, eventos, cache, SRM e taxa de falsos alertas antes de uma decisão comercial.
Um A/A não garante que todo futuro experimento será correto, mas revela falhas estruturais. Execute quando a plataforma é nova, quando a unidade muda ou após uma migração relevante.
Não procure “vencedor” no A/A. Diferenças ocasionais são esperadas; o objetivo é validar distribuição e comportamento estatístico.
Do vencedor ao rollout
Um resultado positivo não exige liberar cem por cento imediatamente. Aumente exposição gradualmente, monitore guardrails e preserve rollback.
Compare o efeito durante o teste e depois do lançamento. Mudança de população, saturação ou novidade pode reduzir o ganho.
Arquive hipótese, código, amostra, intervalos, decisão e data de remoção. O histórico evita repetir testes e transforma CRO em memória organizacional.
Perguntas frequentes
Server-side é sempre melhor?
Não. É adequado para mudanças profundas e controle de renderização; testes simples podem usar outras abordagens.
O que é SRM?
É uma diferença estatisticamente inesperada entre a divisão planejada e observada, sinal de possível falha de dados ou atribuição.
Preciso de cookie?
Não sempre. Usuários autenticados podem usar identificador interno; visitantes anônimos exigem estratégia estável e compatível com privacidade.
Google pode indexar uma variante?
Pode rastrear versões acessíveis. Use canonical, redirects temporários e não trate o bot de forma especial.
Quanto tempo deve durar?
O suficiente para amostra, ciclos e atraso definidos, sem ficar ativo além do necessário.
Teste positivo prova causalidade?
Um experimento bem randomizado sustenta inferência causal para a população e período testados, desde que dados e guardrails sejam válidos.
Conclusão
CRO confiável nasce de engenharia e método. A Open Leads conecta mídia, site e mensuração para testar melhorias sem sacrificar SEO ou experiência. Conheça os serviços da Open Leads, leia sobre testes A/B e SEO e veja a árvore de KPIs.
Quer transformar tráfego em oportunidades reais? A Open Leads integra mídia paga, mensuração e criação de sites focados em conversão. Conheça os serviços da Open Leads.
Fontes consultadas
Consulte os materiais originais usados na pesquisa deste artigo.
- Minimize A/B testing impact in Google Search — Google Search Central
- Diagnosing Sample Ratio Mismatch in A/B Testing — Microsoft Research
- Alerting in Microsoft Experimentation Platform — Microsoft Research
- Set-Cookie header — MDN Web Docs
Tags
Escrito por
Equipe Open Leads
