SEO com JavaScript: faça o conteúdo renderizado chegar à busca e às IAs
Resposta direta: sites feitos com JavaScript podem ser rastreados e renderizados pelo Google, mas o conteúdo precisa ficar acessível no HTML final que o buscador processa e as requisições necessárias não podem estar bloqueadas ou falhar. Verifique a resposta inicial, o DOM renderizado, links rastreáveis, status HTTP, diretivas de indexação e console de erros com o Search Console ou Rich Results Test. Para páginas importantes, renderização no servidor ou estática costuma oferecer uma base mais resiliente e rápida; conteúdo que só aparece depois de ações, APIs privadas ou scripts frágeis pode não estar disponível a todos os crawlers e sistemas de IA.
A discussão sobre JavaScript e SEO costuma cair em dois extremos: “o Google não lê JavaScript” ou “qualquer página JavaScript será indexada automaticamente”. Nenhuma simplificação ajuda a diagnosticar uma página concreta. O Google descreve um processo em etapas — rastreamento, renderização e indexação — e observa que algumas aplicações dependem de execução de código para mostrar conteúdo. O resultado depende de recursos acessíveis, respostas, renderização e qualidade geral da página.
Para SEO/AEO, a meta não é criar uma versão artificial para bots nem adicionar um arquivo especial de IA por reflexo. É entregar conteúdo útil em uma forma tecnicamente acessível e verificável. A documentação do Google diz que os fundamentos de SEO também se aplicam às experiências de IA na Busca, sem requisitos técnicos adicionais para aparecer em AI Overviews ou AI Mode. Nenhuma implementação garante rastreamento, indexação ou citação; o que a equipe pode controlar é a disponibilidade e a clareza do conteúdo publicado.
As etapas de rastrear, renderizar e indexar
Primeiro, o crawler acessa uma URL e recebe uma resposta HTTP. Ele pode ler o HTML inicial, descobrir links e recursos. Em páginas dependentes de JavaScript, uma etapa de renderização executa código para produzir uma versão da página. Depois, o sistema processa o conteúdo disponível e decide como indexá-lo. Essas etapas podem ocorrer em momentos diferentes, e não existe uma confirmação imediata para toda URL.
Se o HTML inicial é apenas um contêiner vazio, a página depende da renderização para mostrar título, texto e links. Isso pode funcionar para Google Search, mas acrescenta condições: scripts e APIs precisam carregar; não podem ser bloqueados; a resposta não pode falhar; a execução deve completar; e o conteúdo precisa aparecer no DOM renderizado. Se um bot não executar JavaScript, uma camada de HTML inicial vazia também dificulta que ele compreenda o serviço.
Renderização no servidor (SSR), geração estática e pré-renderização podem colocar conteúdo importante no HTML inicial e reduzir dependência de execução posterior. Não são soluções automáticas para arquitetura ruim ou metadados incorretos. Uma página renderizada antecipadamente também precisa responder 200, ter canonical correto, links acessíveis e conteúdo que seja útil a pessoas. O melhor modo depende de atualização, personalização, segurança, experiência e capacidade de manutenção.
HTML inicial e DOM final respondem perguntas distintas
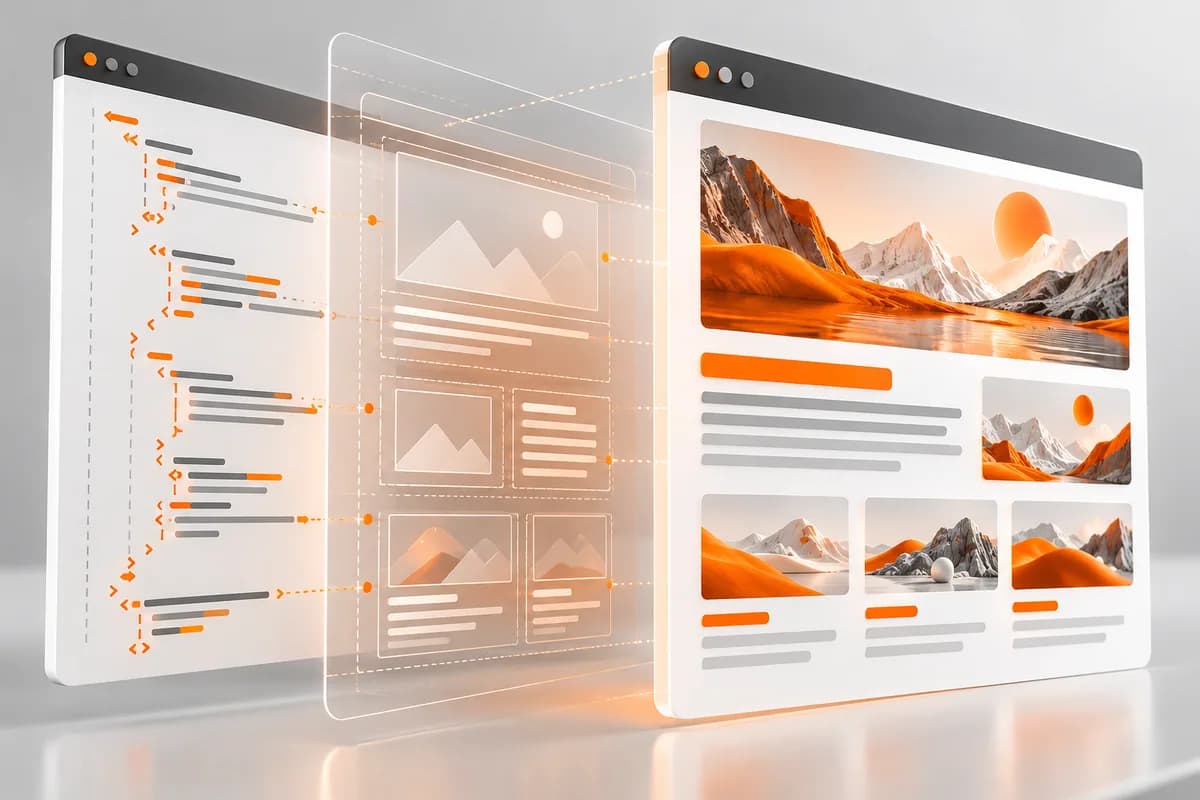
O código-fonte da resposta mostra o que o servidor enviou primeiro. O DOM renderizado mostra o que o navegador ou ferramenta conseguiu construir depois dos scripts. Compare os dois para identificar conteúdo que só aparece após interação, alterações de título, canonical, robots e links. Se algo essencial existe apenas numa chamada que exige autenticação ou numa ação como clicar em “carregar mais”, não presuma que o crawler terá o mesmo percurso de uma pessoa.
Uma ferramenta pode mostrar conteúdo renderizado num teste sem provar que todos os crawlers, regiões, datas ou respostas do servidor se comportarão igual. Repita testes em URLs representativas, consulte logs e verifique falhas de rede e JavaScript. O Search Console permite inspecionar a renderização que o Google recebeu em uma URL verificada. Isso oferece diagnóstico concreto, não uma previsão de citação em resposta generativa.
Links e navegação precisam existir como links
Para descoberta, use elementos de link com endereço real no atributo href. Um botão que executa JavaScript para navegar pode ser acessível a quem usa a aplicação, mas não oferece o mesmo sinal de link rastreável. A documentação do Google recomenda seguir práticas de links rastreáveis e descreve como links inseridos no DOM podem ser processados se adotarem a estrutura apropriada.
Confira menus, paginação, links internos, produtos relacionados e páginas de serviço. Um link que aparece apenas após rolagem ou ação do usuário pode não ser descoberto no mesmo caminho. Teste se ele continua funcional sem código cliente quando necessário. A estrutura interna deve permitir que conteúdos importantes sejam encontrados sem depender de uma busca interna invisível ao crawler.
Também confira se o JavaScript não altera canonical para um endereço diferente do HTML inicial, não injeta noindex inesperado e não substitui o título por um valor incorreto. O Google recomenda manter o canonical inicial e renderizado alinhados. Componentes web devem ser verificados no DOM final; se o conteúdo esperado não estiver lá, não será indexado a partir daquela renderização.
Dados estruturados e conteúdo devem coincidir
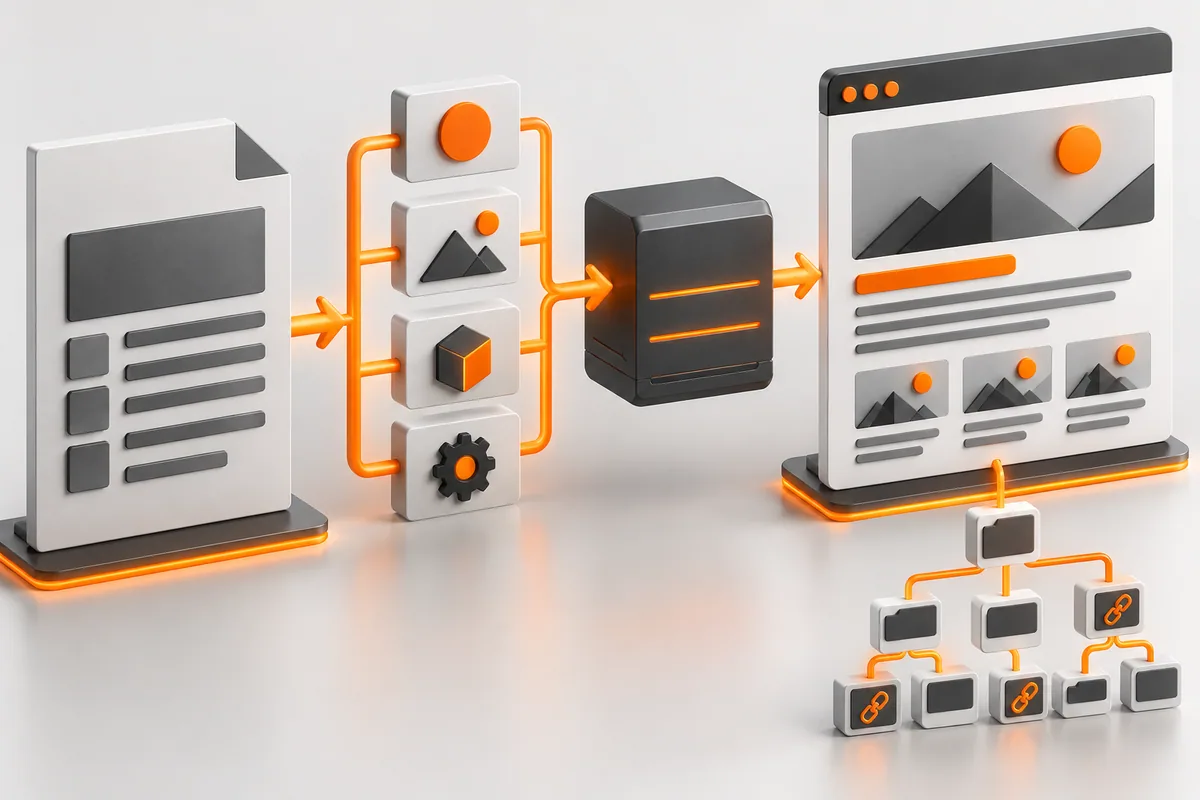
Se a aplicação injeta JSON-LD via JavaScript, valide que o script aparece na renderização e que descreve o mesmo conteúdo visível. Dados estruturados não substituem texto, prova ou informação de serviço. Uma marcação que afirma disponibilidade, preço, autor ou avaliação divergente da página pode induzir erro. Trate markup como descrição legível por máquinas de uma realidade que a pessoa também consegue verificar.
Em páginas de serviço, mantenha nome, escopo, localização atendida e próximos passos claros no HTML. Se uma resposta a uma dúvida é carregada depois de expandir um acordeão, teste se a informação está presente na renderização e se o controle continua acessível. O objetivo é apresentar o conteúdo de maneira útil, não ocultar trechos por expectativa de ranqueamento.
Para busca com IA, a orientação oficial do Google reforça os fundamentos: rastreamento permitido, conteúdo principal em formato textual, links internos e experiência de página. A OpenAI, em orientação para publishers, especifica acesso do OAI-SearchBot para descoberta e citação em ChatGPT Search. Essas orientações não demonstram que um crawler específico execute toda aplicação React, Vue ou outro framework; confirme comportamento, logs e disponibilidade HTML para cada plataforma em vez de assumir equivalência entre bots.
Falhas comuns em páginas JavaScript
Erros de console podem interromper o componente principal; chamadas a API podem retornar 401, 403 ou 500; recursos podem estar bloqueados no robots.txt; uma CDN pode desafiar crawlers; dependências externas podem falhar; e hidratação pode substituir uma página que inicialmente tinha texto por uma tela vazia. Conteúdo carregado de um endpoint instável ou limitado por localização também exige atenção.
Aplicações de página única podem enviar status 200 para rotas inexistentes, fazendo uma página de erro parecer válida. Verifique resposta HTTP por URL, não apenas o que a navegação mostra depois de carregar. Uma rota deve representar conteúdo específico, título único, canonical apropriado e links que levem a recursos relacionados. Não deixe que toda URL desconhecida sirva a mesma página genérica como se fosse conteúdo original.
Renderização dinâmica que detecta bots e fornece uma versão separada foi descrita pelo Google como workaround, não solução de longo prazo. Prefira renderização estática ou no servidor, ou hidratação progressiva, sempre que possível. Se a arquitetura exigir uma alternativa, evite discrepância de conteúdo entre usuários e crawlers: a versão precisa refletir a mesma informação e não ser criada para manipular classificação.
Exemplo prático: catálogo de serviços carregado por API
Uma agência tem páginas de Google Ads, criação de sites e SEO numa aplicação cliente. O servidor entrega um shell com apenas o nome da marca; depois JavaScript consulta uma API e monta título, descrição, links e formulário. No computador da equipe tudo funciona, mas parte das páginas no Search Console aparece com pouco conteúdo. A equipe compara resposta inicial e DOM renderizado e encontra uma chamada que às vezes responde lentamente e um bloqueio de recurso na CDN.
A correção disponibiliza os textos e links principais no HTML gerado no servidor e mantém a API para informações dinâmicas não essenciais. A equipe confirma que rotas desconhecidas retornam 404, titles e canonicals são únicos, formulários funcionam com teclado e URLs de imagens não falham. Em seguida, inspeciona páginas representativas no Search Console e acompanha relatórios de rastreamento. A melhoria torna a experiência mais resiliente, mas a equipe não conclui que por isso será citada por uma IA.
A Open Leads pode apoiar projetos de criação e otimização digital; veja os serviços, leia outros materiais no blog e consulte Google Partner quando essa credencial for relevante.
Checklist para auditar uma página JavaScript
- A URL retorna o status HTTP esperado e não exige sessão para conteúdo público.
- HTML inicial e DOM renderizado contêm título, conteúdo essencial e links.
- Scripts, APIs, imagens e estilos necessários estão acessíveis ao crawler.
- Links internos têm href rastreável e apontam para rotas específicas.
- Canonical, robots e dados estruturados permanecem consistentes após renderização.
- Erros de console e chamadas falhas foram testados em páginas representativas.
- Rotas inexistentes retornam status de erro real, em vez de um shell 200 genérico.
- Conteúdo pode ser lido sem depender de uma interação indisponível a crawlers.
- URLs importantes foram inspecionadas e seu comportamento está sendo monitorado.
Perguntas frequentes
O Google consegue indexar sites feitos em JavaScript?
Sim, o Google descreve rastreamento, renderização e indexação de aplicações JavaScript. Isso não garante que todo conteúdo será renderizado ou indexado; teste cada rota.
Preciso migrar todo site para SSR?
Não necessariamente. Avalie criticidade, estabilidade e custo. SSR ou geração estática pode ajudar a expor conteúdo essencial e reduzir dependências, mas arquitetura deve atender também à experiência e manutenção.
Todo crawler de IA renderiza JavaScript?
Não presuma isso. As capacidades variam por sistema. Verifique documentação e logs do crawler específico e disponibilize conteúdo público principal de forma clara.
JavaScript noindex pode ser lido?
O Google pode processar meta tags após renderização, mas diretivas inconsistentes entre HTML inicial e DOM final podem criar comportamento inesperado. Mantenha-as claras e teste a versão renderizada.
Renderização garante citação em AI Overviews?
Não. Ela ajuda a tornar conteúdo acessível, mas rastreamento, indexação, seleção e citação não são garantidos.
Quer transformar tráfego em oportunidades reais? A Open Leads integra mídia paga, mensuração e criação de sites focados em conversão. Conheça os serviços da Open Leads.
Fontes consultadas
Consulte os materiais originais usados na pesquisa deste artigo.
- Understand JavaScript SEO Basics — Google Search Central
- Fix Search-Related JavaScript Problems — Google Search Central
- AI features and your website — Google Search Central
- Publishers and Developers - FAQ — OpenAI Help Center
Tags
Escrito por
Equipe Open Leads
