Robots.txt para buscas com IA: diferencie Search, recuperação e treinamento
Resposta direta: para controlar acesso de crawlers de busca e de serviços de IA, identifique primeiro qual robô e qual finalidade você quer permitir ou limitar, consulte a documentação oficial do serviço e teste as regras do robots.txt por agente. Googlebot controla o rastreamento usado na Pesquisa Google e em recursos de IA dentro da Busca; o token Google-Extended trata de outros usos de conteúdo em sistemas Google, não funciona como bloqueio de indexação. A OpenAI distingue OAI-SearchBot, usado para busca, de GPTBot, associado a possível treinamento. Robots.txt não protege conteúdo privado e não garante que a página saia do índice.
“Bloquear a IA” parece uma única decisão, mas envolve objetivos diferentes: ser encontrado em busca, aparecer como fonte em respostas, limitar treinamento de modelos ou impedir que páginas internas sejam rastreadas. Cada produto pode usar agentes, regras e consequências próprias. Uma diretiva feita para uma finalidade pode afetar outra de forma diferente ou não afetá-la. Antes de editar o arquivo, defina a política editorial e jurídica da empresa e não copie uma lista de agentes sem entender a função declarada por quem os opera.
Para uma estratégia de SEO e AEO, disponibilidade técnica é apenas uma parte. Um crawler autorizado não garante indexação, citação ou tráfego. A documentação do Google diz que os fundamentos de SEO continuam relevantes para seus recursos de IA e que não existem requisitos técnicos especiais para aparecer neles. A OpenAI também informa como publishers podem permitir acesso do OAI-SearchBot e acompanhar referências. Essas orientações não são uma garantia de inclusão ou recomendação editorial.
Quatro conceitos que não devem ser misturados
Rastreamento é a busca automatizada por uma URL e a leitura de seu conteúdo. Indexação é o processamento e armazenamento que pode permitir exibição em resultados. Uso para recuperação ou busca significa que um serviço acessa páginas para responder a uma pergunta com referências. Treinamento é um uso distinto do conteúdo em processos de desenvolvimento de modelos. A regra aplicável a um agente pode afetar uma dessas etapas sem controlar todas as outras.
Também é diferente impedir acesso a uma área privada. Robots.txt é um protocolo de cooperação voluntária com crawlers, não uma autenticação. Se uma página contém informação que não deveria ser pública, exija login, controle acesso no servidor ou remova o recurso da internet. Não publique um segredo e confie num comando de rastreamento para escondê-lo.
Robots.txt não é noindex
O arquivo robots.txt orienta agentes compatíveis sobre quais caminhos podem buscar. Um bloqueio pode impedir o crawler de ler a página, mas a URL ainda pode ser conhecida e eventualmente aparecer em resultados sem uma descrição, se outros sites a vincularem. Para solicitar que Google não indexe uma página, a documentação recomenda permitir o rastreamento e aplicar um controle de indexação como meta robots noindex, ou proteger a página por autenticação. Se o robô não consegue acessar o HTML, também pode não conseguir ler o noindex nele.
Esse detalhe é uma fonte comum de configuração contraditória: um caminho é bloqueado no robots.txt e ao mesmo tempo recebe noindex dentro da página. Como o crawler está impedido de buscar o HTML, ele talvez não veja a instrução noindex. Para conteúdo que deve permanecer fora do índice, escolha o mecanismo apropriado ao objetivo e verifique a resposta real do servidor, cabeçalhos e acesso do agente.
Googlebot, Google-Extended e recursos de IA na Busca
Google Search Central afirma que AI Overviews e AI Mode usam os requisitos e fundamentos da Busca. A página precisa estar elegível para aparecer em Google Search com snippet; não há uma otimização técnica especial nem um arquivo textual novo que garanta presença. Para controlar rastreamento na Busca, as diretivas de robots.txt para Googlebot são relevantes. Controles de snippet, como nosnippet, data-nosnippet e max-snippet, podem limitar a apresentação de conteúdo em resultados, inclusive em recursos de IA, conforme o efeito documentado para cada um.
Google-Extended é um token usado em robots.txt, não um novo user-agent HTTP independente. A documentação de crawlers explica que ele dá aos publishers controle sobre usos em determinados sistemas de IA do Google, incluindo treinamento e grounding, e não afeta a inclusão em Google Search nem funciona como sinal de ranking. Isso importa porque bloquear Google-Extended não equivale a tirar uma página do índice nem a impedir Googlebot de rastrear uma página para a Busca.
Evite blocos genéricos que indiscriminadamente bloqueiam Googlebot quando a intenção é limitar apenas um uso específico em outros serviços Google. Revise cada grupo de user-agent no arquivo, a ordem das regras, os caminhos cobertos e a documentação atual. Um wildcard para diretório pode impactar CSS, JavaScript, imagens e páginas que sustentam o conteúdo público. Teste com ferramentas apropriadas e inspecione a versão que o servidor entrega.
OAI-SearchBot e GPTBot: objetivos diferentes
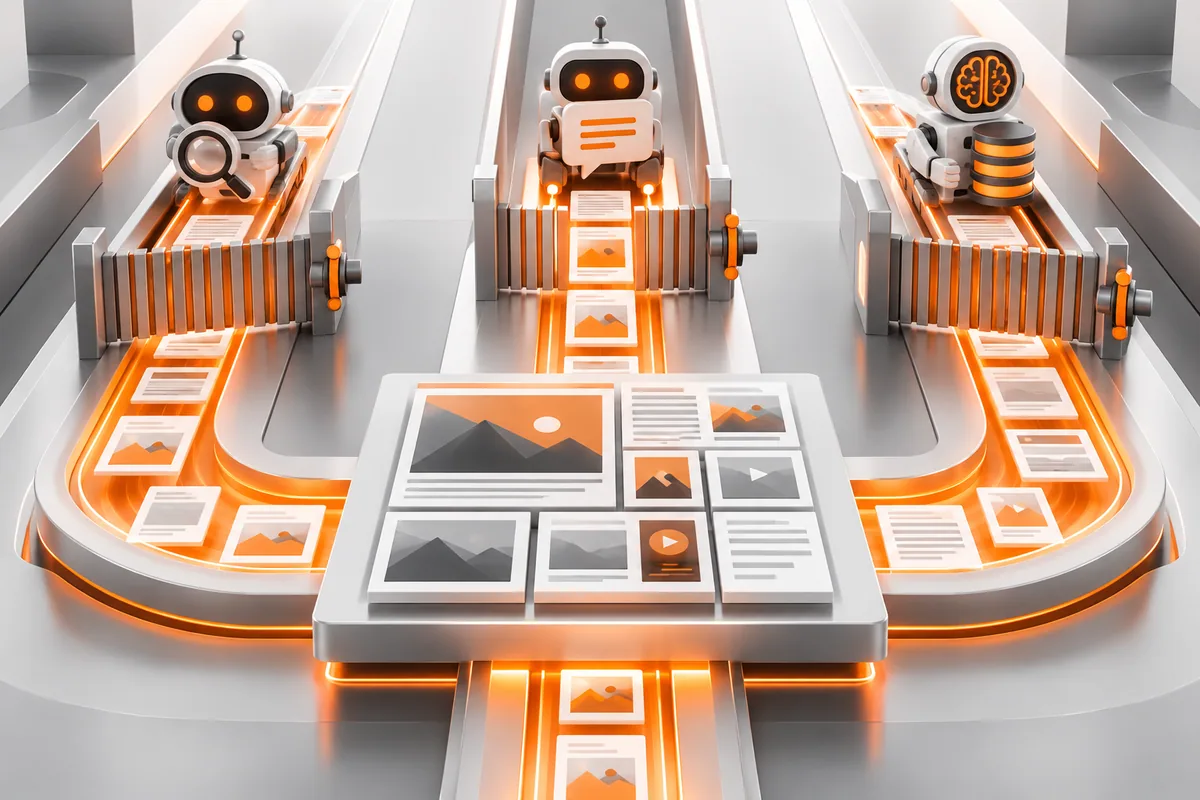
Nas orientações para publishers, a OpenAI descreve OAI-SearchBot como o agente relacionado à descoberta e à exibição de conteúdo em ChatGPT Search. Se a empresa quer que suas páginas possam ser encontradas e citadas nessa experiência, a documentação recomenda não bloquear esse token e conferir se firewall, CDN ou hospedagem também permitem o acesso. A mesma página esclarece que GPTBot pode ser bloqueado por publishers que desejam excluir páginas do possível uso para treinamento de modelos.
Não são a mesma escolha. Uma editora pode querer permitir que conteúdo aberto seja encontrado em busca e, separadamente, restringir o token que comunica uma preferência sobre treinamento. Essa configuração não promete que a página será exibida numa resposta; ela apenas administra um sinal de acesso dentro do protocolo e das políticas publicadas. Para medir referências do ChatGPT, a FAQ informa que URLs de saída podem incluir um parâmetro UTM, sujeito ao funcionamento da experiência e à disponibilidade de dados analíticos.
Antes de adicionar regras, busque os nomes atuais de agentes na documentação oficial e valide a grafia exata. User-agent pode mudar, políticas evoluem e os produtos usam distintos processos. Nunca confie apenas em uma lista de terceiros copiada anos atrás. Regras para agentes desconhecidos também não forçam crawlers que ignoram o Robots Exclusion Protocol a cumprir o pedido.
Como planejar uma política para o site
Comece com inventário de conteúdo e objetivo por área: páginas públicas comerciais, blog, documentos, staging, áreas privadas, resultados de busca interna, parâmetros de filtro, APIs e assets. Determine o que deve ser indexado, o que pode ser rastreado para descoberta, o que contém dados confidenciais e o que não deve ser coletado. A resposta pode variar por seção; por exemplo, um artigo público pode ser útil para busca enquanto páginas administrativas devem exigir autenticação.
Depois construa uma matriz por agente e finalidade. Para cada um, registre: token documentado, proprietário, função declarada, caminhos permitidos, caminhos proibidos, efeito esperado e responsável pela revisão. A equipe de SEO pode cuidar da disponibilidade para Google Search, enquanto jurídico, produto e conteúdo avaliam política de uso para treinamento. Infraestrutura deve verificar se o servidor ou a camada de segurança não bloqueia requisições legítimas por outra regra.
Mantenha regras curtas e explícitas. Um arquivo difícil de entender aumenta risco de bloquear uma área inteira ou permitir algo sem querer. Inclua sitemap quando apropriado e mantenha links XML corretos. Não use robots.txt como estratégia de canonicalização, como proteção de conteúdo, como solução para remover resultados já indexados ou como garantia de privacidade.
Valide o que o servidor realmente entrega
Abra /robots.txt na origem pública e confirme status, tipo de conteúdo, protocolo HTTPS, redirecionamentos e conteúdo atual. Teste regras com uma ferramenta compatível para verificar caminhos permitidos e bloqueados. Examine logs do servidor para identificar requisições dos agentes, códigos HTTP, erros de CDN, desafio anti-bot ou bloqueio geográfico. User-agent pode ser falsificado, então não use somente essa string para conceder acesso sensível; crawlers documentados podem oferecer métodos adicionais de validação.
Depois confira URLs que importam com inspeção do Search Console e navegação independente. Permitir crawl não é o mesmo que indexar; uma página pode ser rastreada e excluída por conteúdo duplicado, baixa qualidade percebida, canonical, erro no servidor ou outros sinais. A busca de IA também depende de requisitos próprios do produto. Não transforme um sucesso de fetch em afirmação de citação ou ranking.
Quando houver mudança, planeje revisão e observação. Atualizações podem levar tempo até que crawlers voltem e processem as novas regras. Mudanças em robots devem ser revisadas por alguém de SEO e alguém de infraestrutura, especialmente quando cobrem padrões amplos. Uma regra simples pode bloquear a renderização se atingir recursos necessários para compreender a página.
Exemplo prático de separação de objetivos
Uma consultoria publica artigos técnicos e páginas de serviço, mantém um ambiente de testes e usa ferramenta de atendimento que não deve aparecer em buscas. O objetivo é manter Google Search habilitado para os artigos, permitir OAI-SearchBot se a empresa deseja descoberta em ChatGPT Search, e considerar a regra GPTBot separadamente com base em sua política de conteúdo. O token Google-Extended é revisado como controle específico de outros usos Google; não é usado como substituto para bloquear ou permitir Google Search.
O ambiente de testes é protegido com autenticação, não apenas com Disallow. O serviço de atendimento também exige login. Páginas públicas indesejadas no índice recebem um controle de noindex conforme a documentação e podem ser retiradas por métodos apropriados se já estiverem indexadas. A equipe verifica que as regras não bloqueiam CSS, imagens essenciais ou páginas comerciais. Um sitemap publicado inclui apenas URLs que devem ser descobertas e consideradas para indexação.
Para criar conteúdo útil a pessoas e potencialmente compreensível para motores de busca, a Open Leads apresenta seus serviços, publica guias em seu blog e mantém informações sobre Google Partner quando relevantes. Nenhuma configuração de crawler garante que uma IA cite uma empresa; ela apenas evita bloqueios acidentais e organiza preferências de acesso.
Checklist para revisar acesso de crawlers
- Escreva separadamente os objetivos de indexação, busca/recuperação, treinamento e privacidade.
- Confirme o agente e o efeito de cada regra em documentação oficial vigente.
- Não confunda Googlebot com Google-Extended nem OAI-SearchBot com GPTBot.
- Não use robots.txt como controle de acesso a material privado.
- Use noindex quando o objetivo for impedir indexação e permita o crawl para que a instrução seja lida.
- Teste regras e confira CDN, firewall, cabeçalhos e status HTTP.
- Inspecione páginas representativas após a mudança e monitore logs.
- Registre responsável e política de revisão para mudanças futuras.
Perguntas frequentes
Bloquear Google-Extended remove meu site do Google Search?
Não. A documentação do Google diz que Google-Extended não afeta a inclusão em Search nem é sinal de ranking. O acesso para Search é controlado pelas regras relevantes para Googlebot.
Robots.txt impede que uma página privada seja lida?
Não de forma segura. O protocolo pede cooperação de crawlers, mas não é autenticação. Use controle de acesso no servidor para informação privada.
Devo bloquear GPTBot e liberar OAI-SearchBot?
Essa é uma escolha editorial e de política de dados. A OpenAI descreve usos diferentes para os dois tokens; decida com base na documentação atual e na preferência da organização.
Permitir um crawler garante citação por IA?
Não. Permitir acesso remove uma possível barreira técnica, mas a inclusão, seleção e citação dependem de sistemas e critérios do serviço, sem garantia.
Robots.txt substitui noindex?
Não. Robots.txt controla rastreamento. Noindex é uma instrução de indexação que o crawler precisa conseguir ler; os controles devem ser escolhidos para o objetivo correto.
Quer transformar tráfego em oportunidades reais? A Open Leads integra mídia paga, mensuração e criação de sites focados em conversão. Conheça os serviços da Open Leads.
Fontes consultadas
Consulte os materiais originais usados na pesquisa deste artigo.
- AI features and your website — Google Search Central
- Google common crawlers and fetchers — Google Crawling Infrastructure
- Publishers and Developers - FAQ — OpenAI Help Center
- RFC 9309: Robots Exclusion Protocol — RFC Editor / IETF
Tags
Escrito por
Equipe Open Leads
