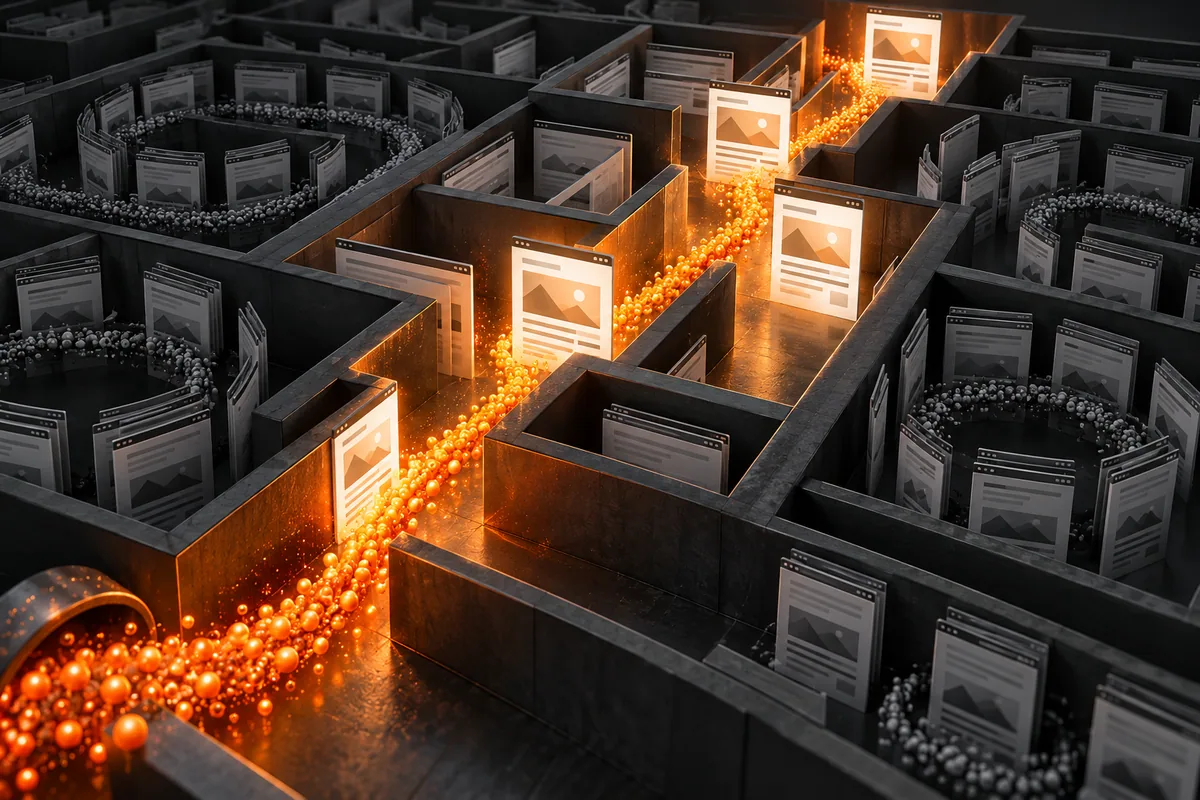
Resposta direta: a maioria dos sites pequenos e médios não precisa “otimizar crawl budget”. O tema merece prioridade em sites com cerca de um milhão de páginas que mudam moderadamente, dez mil ou mais páginas que mudam muito rápido, ou grande volume de URLs marcadas como descobertas e ainda não indexadas. Antes de agir, confirme o problema nos relatórios e logs; rastreamento, indexação e posicionamento são etapas diferentes.
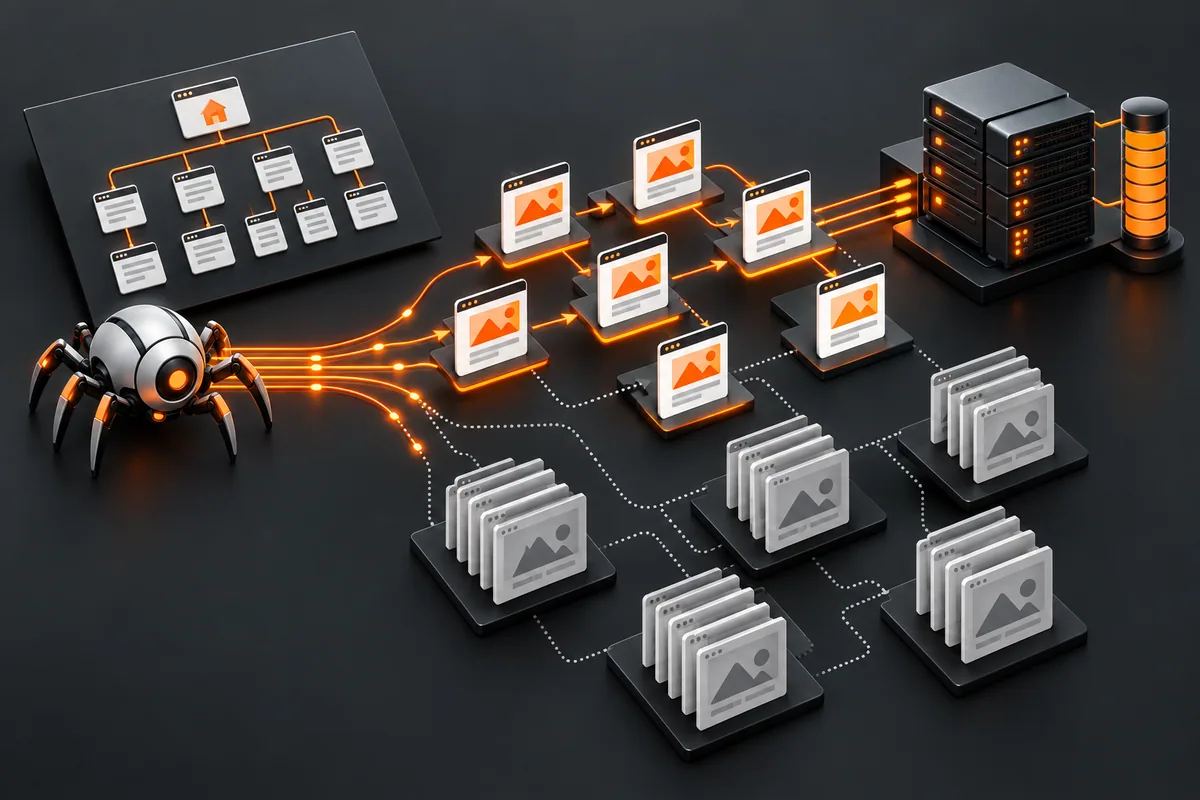
Orçamento de rastreamento é a combinação entre quanto o Googlebot consegue solicitar sem prejudicar o servidor e quanto deseja rastrear conforme popularidade, atualização e qualidade percebida. Não é um crédito diário fixo que possa ser comprado.
Dois componentes do orçamento
Limite de capacidade
O Google ajusta a intensidade para não sobrecarregar o host. Respostas rápidas e estáveis permitem mais requisições; erros 5xx, tempo alto e 429 fazem o sistema reduzir.
A capacidade é observada por hostname. Subdomínios e infraestrutura compartilhada exigem análise própria. Aumentar servidor sem corrigir URLs inúteis pode apenas acelerar desperdício.
Demanda de rastreamento
O robô prioriza URLs que parecem importantes ou que precisam de atualização. Popularidade, frequência de mudança, novidade e qualidade influenciam essa demanda.
Uma página disponível não ganha rastreamento ilimitado. O buscador distribui recursos entre muitas propriedades e evita repetir solicitações sem necessidade.
Quando não é crawl budget
Se uma página foi rastreada e não indexada, o problema pode ser duplicidade, baixa utilidade, canonical, noindex ou processamento. Se nem foi descoberta, pode faltar link interno ou sitemap.
Queda de posição não prova falta de rastreamento. Analise conteúdo, intenção, concorrência, links, experiência e ações manuais.
Um sitemap enviado também não garante indexação. Ele informa URLs preferidas e datas de modificação; o buscador ainda avalia cada uma.
Sinais que justificam investigação
- Muitas URLs importantes permanecem como descobertas e não indexadas.
- Páginas atualizadas demoram muito para ser rastreadas.
- Logs mostram Googlebot concentrado em filtros e duplicatas.
- Erros de servidor aparecem quando o bot aumenta a frequência.
- Grandes seções não recebem solicitações apesar de links e sitemap.
- Parâmetros criam espaços praticamente infinitos.
Compare tendências, não um único dia. Migração, lançamento ou instabilidade temporária alteram a atividade.
Comece pelo inventário de URLs
Liste URLs indexáveis, bloqueadas, redirecionadas, canônicas e removidas. Agrupe por template: produto, categoria, filtro, busca interna, artigo, perfil e documento.
Conte quantas combinações os filtros podem criar. Cor, tamanho, ordenação, paginação e parâmetros de sessão multiplicam caminhos. O usuário precisa de algumas combinações; o robô não precisa de todas.
Corrija a geração na origem. Bloquear depois no robots.txt evita rastreamento, mas URLs já conhecidas ainda podem aparecer sem conteúdo, e o robô não verá canonical ou noindex dentro da página bloqueada.
Duplicatas e canonicals
Escolha uma URL principal por conteúdo equivalente. Use links internos, sitemap, redirects e rel canonical de forma coerente. Sinais conflitantes obrigam o buscador a explorar alternativas.
Canonical é uma indicação forte, não comando absoluto. Não aponte dezenas de páginas realmente diferentes para uma página genérica apenas para reduzir volume.
Normalize protocolo, host, barras, maiúsculas e parâmetros. Redirecionamentos em cadeia consomem tempo e deixam manutenção mais difícil.
Soft 404 e páginas vazias
Uma página sem produto que retorna 200 e diz “não encontrado” pode ser tratada como soft 404. Use 404 ou 410 quando o recurso acabou sem substituto.
Se existe alternativa equivalente, redirecione para ela. Não envie todos os produtos removidos para a home; isso confunde usuário e buscador.
Resultados internos sem conteúdo, calendários infinitos e páginas de tag vazias devem ter uma política clara de criação e remoção.
Servidor, cache e códigos HTTP
Mantenha resposta previsível. Erros 500, 502, 503 e timeouts reduzem capacidade. Use 429 apenas quando realmente necessário e corrija a causa.
ETag e Last-Modified podem permitir respostas condicionais 304 quando o recurso não mudou. Isso economiza transferência, embora ainda exista uma requisição.
Não devolva 200 para tudo. Códigos corretos ajudam o robô a entender remoção, mudança e indisponibilidade temporária.
Sitemaps úteis
Inclua somente URLs canônicas que você deseja ver indexadas. Separe arquivos por tipo ou atualização quando isso facilitar diagnóstico.
Use lastmod apenas com a última alteração significativa da página, não a data em que o sitemap foi gerado. Datas falsas perdem valor operacional.
Respeite limites documentados e use índice de sitemaps quando necessário. Mantenha o arquivo acessível e acompanhe processamento no Search Console.
Links internos orientam prioridade
Páginas importantes devem receber links de navegação, categorias, hubs e conteúdo relacionado. URLs órfãs dependem de sitemap e são mais difíceis de contextualizar.
Use links HTML rastreáveis com destinos reais. Eventos que só funcionam após interação complexa podem ocultar caminhos.
A profundidade não tem um número mágico, mas áreas valiosas não deveriam exigir uma sequência longa de cliques desde páginas fortes.
Robots.txt e noindex têm funções diferentes
robots.txt controla acesso do rastreador. noindex é uma diretiva lida depois que a página é acessada. Bloquear uma URL e esperar que o Google veja noindex é contraditório.
Para remover conteúdo já indexado, siga o fluxo adequado: permita acesso ao noindex, use status correto ou ferramenta temporária conforme o caso. Não trate robots.txt como ferramenta universal de remoção.
Teste regras, principalmente curingas e parâmetros. Um bloqueio amplo pode atingir CSS, JavaScript ou páginas comerciais.
Análise de logs
Logs do servidor mostram o que foi solicitado, quando, com qual status e tempo de resposta. Verifique a identidade do Googlebot pelos métodos oficiais; user-agent sozinho pode ser falsificado.
Calcule requisições por template, status, diretório e parâmetro. Compare URLs importantes versus desperdício. Proteja endereços IP e outros dados conforme política.
Relatórios do Search Console agregam tendências. Logs oferecem detalhe. Use os dois, sem esperar números idênticos.
Exemplo de e-commerce
Uma loja tem cinquenta mil produtos, mas filtros geram milhões de URLs. Logs mostram rastreamento em ordenação e combinações vazias. A equipe limita geração, consolida canonicals, corrige links e mantém sitemap com produtos disponíveis.
Depois acompanha tempo até novo produto ser rastreado, proporção de requisições úteis e erros do servidor. Não mede sucesso apenas por volume total de bot.
Exemplo de portal editorial
Um portal publica centenas de matérias por dia. Mantém sitemap de notícias conforme requisitos, atualiza lastmod corretamente, melhora hubs e reduz páginas de calendário sem valor.
Conteúdo antigo relevante continua acessível; duplicatas de impressão e parâmetros sociais são consolidadas.
Exemplo de documentação SaaS
Versões e idiomas criam caminhos parecidos. Cada página indica idioma e versão, a navegação separa conteúdo vigente e URLs removidas retornam status adequado.
O sitemap privilegia documentação atual sem apagar histórico necessário. Links de produto apontam para a versão correta.
Plano de ação em quatro semanas
- Na primeira semana, capture relatórios, logs e inventário sem alterar regras.
- Na segunda, corrija erros 5xx, loops e espaços infinitos.
- Na terceira, alinhe canonical, sitemap e links internos.
- Na quarta, compare rastreamento de páginas prioritárias e tempo de descoberta.
Faça mudanças em blocos rastreáveis. Se robots, arquitetura e servidor mudam ao mesmo tempo, fica difícil aprender.
Rastreamento e respostas de IA
Conteúdo acessível, bem ligado e atualizado facilita descoberta por sistemas de busca, mas não garante citação por uma IA. Cada plataforma tem políticas, índices e critérios próprios.
Publique autoria, fontes, datas e respostas verificáveis. Isso melhora clareza para pessoas e máquinas sem prometer seleção automática.
Checklist de diagnóstico
- O site está na escala em que orçamento importa.
- Há evidência em logs e Search Console.
- URLs prioritárias estão claramente definidas.
- Filtros e parâmetros têm política.
- Canonicals e links são coerentes.
- Sitemap contém apenas URLs desejadas.
- lastmod representa mudança real.
- 404, 410 e redirects estão corretos.
- Servidor não apresenta picos de 5xx.
- Robots.txt foi testado.
- Googlebot foi verificado.
- Resultado será medido por descoberta útil.
Erros frequentes
Comprar “mais crawl”, alterar crawl rate sem necessidade, bloquear URLs com noindex no robots.txt e enviar toda variação ao sitemap são erros comuns. Outro é confundir mais solicitações com mais indexação.
Também é arriscado remover conteúdo útil apenas para diminuir contagem. O objetivo é reduzir desperdício, não empobrecer o site.
Indicadores de sucesso
Meça a parcela de requisições em URLs prioritárias, tempo entre publicação e primeiro rastreamento, frequência de atualização de páginas críticas, erros por status e resposta do servidor. Compare antes e depois em janelas equivalentes.
Inclua indicadores de resultado: páginas válidas indexadas, tráfego orgânico qualificado e conversões. Uma melhora técnica sem efeito imediato ainda pode reduzir risco, mas precisa de objetivo explícito.
Evite meta de “mais crawl”. A meta é rastreamento suficiente das páginas certas, com servidor estável e menos espaço inútil.
Perguntas frequentes
Todo site tem crawl budget?
Existe uma capacidade prática, mas a maioria dos sites menores é rastreada adequadamente sem otimização específica.
Sitemap aumenta o orçamento?
Não diretamente. Ele ajuda descoberta e informa URLs preferidas e mudanças.
Mais rastreamento melhora ranking?
Não necessariamente. Rastreamento permite processamento; relevância e qualidade determinam outras etapas.
Devo bloquear filtros no robots.txt?
Depende. Primeiro controle geração e links; avalie indexação existente e o efeito de impedir canonical ou noindex.
Como verificar o Googlebot?
Use a validação de DNS indicada pelo Google, não apenas o texto do user-agent.
Crawl budget ajuda uma IA a citar minha marca?
Ele pode facilitar descoberta de conteúdo em busca, mas não garante acesso, uso ou citação por sistemas de IA.
Conclusão
O melhor trabalho de crawl budget elimina URLs sem valor e fortalece caminhos importantes com evidência. A Open Leads integra SEO, conteúdo e desenvolvimento. Leia também sobre renderização JavaScript para SEO e consulte o blog.
Quer transformar tráfego em oportunidades reais? A Open Leads integra mídia paga, mensuração e criação de sites focados em conversão. Conheça os serviços da Open Leads.
Fontes consultadas
Consulte os materiais originais usados na pesquisa deste artigo.
- Large site owner guide to managing crawl budget — Google Search Central
- Troubleshoot crawling errors — Google Search Central
- Build and submit a sitemap — Google Search Central
- Canonicalization — Google Search Central
Tags
Escrito por
Equipe Open Leads
