O arquivo llms.txt pode oferecer a agentes de IA um mapa legível do conteúdo, mas não substitui robots.txt, sitemap, SEO técnico nem páginas realmente úteis. Ele é uma proposta aberta, não um padrão universal de ranking e não garante que uma IA rastreie, indexe ou cite a empresa. Para aumentar a chance de descoberta, priorize acesso técnico correto, conteúdo verificável e identidade de marca consistente.
O interesse por llms.txt cresceu porque sites modernos podem ser difíceis de consumir: navegação em JavaScript, banners, páginas extensas e informação espalhada. A proposta sugere um arquivo Markdown na raiz com resumo e links selecionados. A ideia é facilitar o contexto para modelos e agentes. Isso é diferente de controlar permissão de rastreamento.
O que é llms.txt
O projeto llms.txt descreve um arquivo em Markdown, normalmente publicado em /llms.txt, que apresenta o site e organiza links importantes com pequenas descrições. Ele pode apontar para documentação, serviços, políticas, guias e versões Markdown de páginas. A estrutura procura ser simples para humanos e sistemas automatizados.
O repositório público do projeto oferece especificação, exemplos e bibliotecas. Ainda assim, adoção varia entre fornecedores. Trate o arquivo como camada experimental de descoberta, não como requisito oficial para aparecer em respostas. Uma convenção pode ser útil sem ter efeito comprovado sobre ranking.
O que robots.txt faz
Robots.txt é um mecanismo de controle de rastreamento na raiz do host. O Robots Exclusion Protocol foi formalizado no RFC 9309. Ele permite declarar regras por user-agent, como caminhos permitidos ou bloqueados. Não é um recurso de segurança: URLs bloqueadas ainda podem ser descobertas por links, e conteúdo sensível deve depender de autenticação e autorização.
O arquivo também não descreve o melhor conteúdo. Ele responde principalmente onde um rastreador que respeita o protocolo pode ir. Um erro de sintaxe ou uma regra ampla pode impedir mecanismos de acessar áreas públicas. Por isso, controle de acesso e curadoria de conteúdo devem permanecer separados.
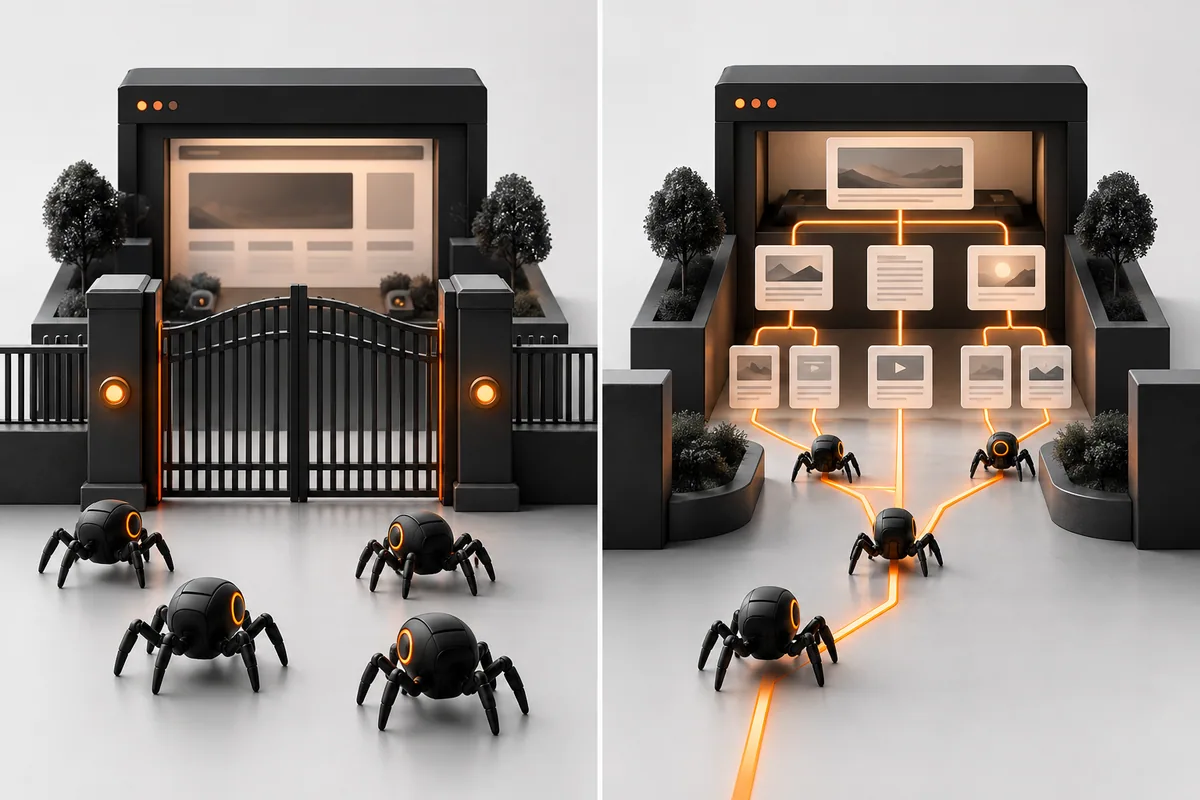
Rastreadores da OpenAI têm funções diferentes
A documentação oficial da OpenAI lista agentes com finalidades distintas. O OAI-SearchBot está relacionado à possibilidade de páginas aparecerem em resultados de busca do ChatGPT. O GPTBot está relacionado ao rastreamento que pode ser usado para aprimorar modelos. O ChatGPT-User representa ações iniciadas por usuários e não deve ser tratado como um rastreador automático comum.
As regras precisam usar o identificador certo para a intenção certa. Permitir busca não exige aceitar toda finalidade; bloquear um agente não significa bloquear os demais. Consulte a página oficial de crawlers antes de editar, porque nomes, faixas e orientações podem mudar.
Não use endereço IP copiado de uma lista antiga como única defesa. Quando o fornecedor publica faixas atuais, a verificação pode complementar user-agent e logs. Para conteúdo privado, autenticação continua sendo o controle real.
llms.txt não concede permissão
Publicar links em llms.txt não supera uma regra de robots.txt, autenticação, noindex ou limitação técnica. O arquivo é um mapa, não uma chave. Se ele aponta para páginas bloqueadas ou inexistentes, cria apenas uma lista inconsistente.
Da mesma forma, liberar rastreamento não obriga um sistema a usar o conteúdo. O rastreador pode decidir quando acessar e o produto pode ter outros critérios de seleção, qualidade, relevância e apresentação. Não há botão confiável de “ser citado por IA”.
O que realmente aumenta a citabilidade
Respostas diretas e verificáveis
Comece páginas com uma resposta clara. Depois explique condições, processo, limitações e fontes. Afirmações específicas são mais úteis quando podem ser verificadas. Evite superlativos sem evidência, números inventados e depoimentos inexistentes.
Identidade consistente
Use o mesmo nome da empresa, descrição de serviços, localização quando relevante e informações de contato em páginas institucionais. Dados estruturados podem ajudar máquinas a entender entidades, mas devem corresponder ao conteúdo visível. O guia de SEO de entidade detalha essa consistência.
Arquitetura navegável
Serviços e conteúdos importantes precisam receber links internos descritivos. Sitemap auxilia descoberta, canonical evita sinais conflitantes e status HTTP deve refletir o estado real. Um llms.txt bem escrito não conserta página lenta, órfã ou duplicada.
Fontes e autoria
Cite documentação primária perto da afirmação que ela sustenta. Informe autor ou equipe responsável, data e atualização quando aplicável. A transparência não garante citação, mas torna o conteúdo mais avaliável para pessoas e sistemas.
Como criar um llms.txt responsável
Inclua nome do site, resumo factual e grupos pequenos de links prioritários. Prefira URLs canônicas estáveis. Escreva descrições que expliquem o que existe na página, sem repetição de palavras-chave. Se houver documentação técnica em Markdown, aponte para ela; se não houver, não fabrique cópias divergentes.
Uma estrutura possível tem título, breve contexto, seção de serviços, seção de conteúdo e links opcionais. O arquivo deve ser curto o bastante para orientar. Listar todas as URLs transforma curadoria em outro sitemap, sem o benefício do foco.
Atualize quando serviços e rotas mudarem. Teste resposta 200, tipo de conteúdo e links. Não exponha endpoints privados, arquivos internos ou conteúdo que não deveria ser público. Tudo no arquivo deve ser seguro para qualquer visitante.
Auditoria conjunta de acesso
Revise robots.txt, meta robots, cabeçalhos X-Robots-Tag, canonical, sitemap e respostas do servidor. Uma página pode estar permitida no robots e marcada noindex; pode estar no sitemap e redirecionar; pode ser pública e não ter links internos. Cada sinal tem função diferente.
Analise logs para saber se user-agents conhecidos visitam o site, sem confundir solicitação com indexação ou citação. Um acesso prova apenas que houve requisição. Métricas de referência e analytics podem mostrar visitas de produtos, mas atribuição é incompleta.
Exemplo prático
Uma agência publica llms.txt com links para página institucional, serviços de tráfego pago, criação de sites, política editorial e guias fundamentais. Antes disso, confirma que as páginas respondem 200, estão indexáveis, têm canonical próprio e aparecem na navegação.
O robots.txt permite o rastreador de busca desejado e bloqueia áreas administrativas para todos os agentes relevantes. O site não coloca segredos em caminhos públicos. A equipe revisa os documentos trimestralmente e remove links antigos. O arquivo melhora organização, mas o investimento principal continua no conteúdo e na estrutura.
Erros comuns
- Apresentar llms.txt como padrão obrigatório ou fator de ranking.
- Acreditar que ele substitui robots.txt ou sitemap.
- Publicar URLs bloqueadas, duplicadas ou quebradas.
- Copiar uma lista enorme sem curadoria.
- Liberar conteúdo confidencial para tentar ganhar visibilidade.
- Confundir visita de crawler com indexação ou citação.
- Usar o mesmo tratamento para agentes com finalidades diferentes.
- Fazer afirmações de autoridade sem fontes verificáveis.
- Esquecer de atualizar o arquivo após migrações.
Checklist para SEO e IA
- Definir quais páginas públicas merecem descoberta.
- Verificar user-agents e orientação oficial atual.
- Configurar robots.txt sem bloquear áreas importantes.
- Proteger conteúdo privado com autenticação.
- Manter sitemap apenas com URLs canônicas indexáveis.
- Criar llms.txt curto, factual e opcional.
- Escrever respostas diretas e citar fontes primárias.
- Fortalecer páginas de empresa, serviços e autoria.
- Usar links internos descritivos.
- Monitorar logs, referências e erros sem prometer citação.
Posicionamento da Open Leads
A Open Leads combina SEO, criação de sites e tráfego pago para tornar a presença digital compreensível em vários pontos da jornada. Em projetos voltados a buscas e IAs, o trabalho começa por arquitetura, conteúdo e informações consistentes. Um arquivo experimental entra depois, como complemento.
Para aprofundar o tema, leia o guia sobre como tornar uma empresa mais citável em buscas com IA. O princípio permanece: seja fácil de acessar quando apropriado, fácil de entender e fácil de verificar.
Como priorizar o trabalho
Se o site ainda tem páginas sem título claro, conteúdo duplicado, navegação fraca ou informações institucionais contraditórias, resolva isso antes de investir muito tempo no arquivo experimental. Esses problemas afetam pessoas, mecanismos tradicionais e agentes. Em seguida, confirme acesso técnico, sitemap e canonicals. Só depois crie o mapa editorial.
Escolha cinco a vinte recursos realmente representativos e pergunte se um leitor externo entenderia a empresa apenas por eles. Inclua páginas que explicam serviços, processo, autoria, contato e conteúdos de referência. Não destaque páginas puramente promocionais em detrimento das que respondem perguntas.
Registre a data de cada revisão e associe o arquivo ao processo de publicação. Quando uma URL mudar, o redirecionamento e o llms.txt devem ser atualizados juntos. Essa disciplina vale mais que publicar o arquivo uma vez e esquecê-lo. A citabilidade é resultado acumulado de informações claras, não um ajuste isolado.
Perguntas frequentes
llms.txt melhora o ranking no Google?
Não há base para tratá-lo como fator de ranking do Google. Ele é uma proposta voltada a agentes e modelos. SEO tradicional continua dependendo de conteúdo, acesso e sinais relevantes.
llms.txt garante citação no ChatGPT?
Não. Nenhum arquivo garante rastreamento, inclusão ou citação. Ele pode facilitar contexto para sistemas que decidam utilizá-lo.
Posso bloquear treinamento e permitir busca?
A documentação da OpenAI apresenta agentes distintos para finalidades diferentes. Configure regras específicas após conferir os nomes e orientações atuais.
Robots.txt protege conteúdo confidencial?
Não. Ele orienta rastreadores cooperativos, mas não impede acesso direto. Use autenticação, autorização e controles de servidor.
Preciso publicar todo o site em Markdown?
Não. A proposta permite apontar para recursos úteis, mas duplicar todo conteúdo cria manutenção. Priorize páginas canônicas e versões que realmente possam ser mantidas.
Como medir se funcionou?
Observe logs, tráfego de referência, erros e descoberta das páginas, mas interprete com cautela. Visita não prova uso em resposta, e ausência de referência não prova ausência de leitura.
Quer transformar tráfego em oportunidades reais? A Open Leads integra mídia paga, mensuração e criação de sites focados em conversão. Conheça os serviços da Open Leads.
Fontes consultadas
Consulte os materiais originais usados na pesquisa deste artigo.
- Overview of OpenAI Crawlers — OpenAI Developers
- The llms.txt proposal — llms.txt
- llms-txt repository — Answer.AI on GitHub
- Robots.txt Introduction — Google Search Central
- Robots Exclusion Protocol — RFC Editor
Tags
Escrito por
Equipe Open Leads
